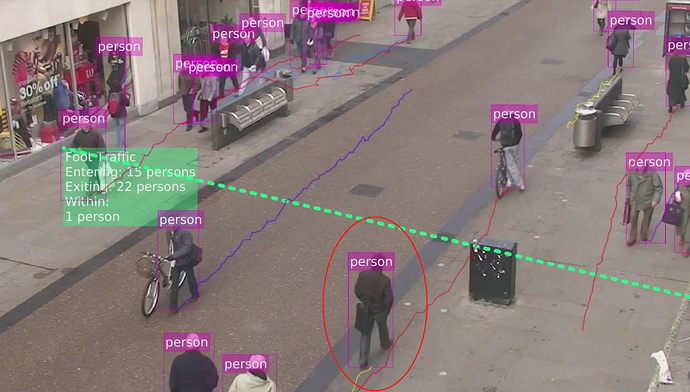
关于 brainframe 我有几个问题,能否回答一下?
- Logo 定制。能否在 brainframe 上定制我们自己的 logo?
- 关于与其他系统的集成,告警信息能否推送到其他软件平台?
- 告警前后的图片和视频存储。能否保存告警时间点前后的视频/图片?
- 视频中显示的信息、文字(例如“person”、“car”)和框的样式能否修改,还是固定格式?或者由算法胶囊决定?
- 对于“detector_people_and_vehicles_fast.cap”,我怎样才能把“person”改成“people”,或者把“car”改成“汽车”?
感谢你在论坛上发帖。以下是产品经理的回答。
- Logo 定制。能否在 brainframe 上定制我们自己的 logo?
目前这不是一个标准支持的功能,但我们为企业客户做过定制 logo。
- 关于与其他系统的集成,告警信息能否推送到其他软件平台?
当然可以!我们的 REST API 记录在 BrainFrame API 文档中,包含所有与告警(alerts)和报警(alarms)相关的 API。我也建议你试试我们的 Python 库(它是 REST API 的封装),可以在这里下载:下载 - BrainFrame 文档。Python 库提供了 api.get_all_alerts()、api.get_alert_frame(alert_id) 等实用方法(这些功能也都可以通过 REST API 实现)。
- 告警前后的图片和视频存储。能否保存告警时间点前后的视频/图片?
目前没有视频存储。我们支持的是“告警帧(Alert Frames)”,即告警开始时拍下的一张图片。也许我们可以增加告警结束时再拍一张图片的支持?
- 视频中显示的信息、文字(例如“person”、“car”)和框的样式能否修改,还是固定格式?或者由算法胶囊决定?
“person”“car”“train”这类名称是由算法胶囊决定的。算法胶囊是开源格式,如果你想做自己的算法胶囊,完全可以(源代码在这里:github.com/opencv/open_vision_capsules)。至于屏幕上渲染什么,客户端工具栏里有“渲染配置(Render Configuration)”,你可以决定叠加显示哪些内容。此外,算法胶囊有可配置的选项。在“全局插件配置(Global Plugin Configuration)”下选择“Detector Person and Vehicles”,就可以选择过滤掉人、车辆或动物。
- 对于“detector_people_and_vehicles_fast.cap”,我怎样才能把“person”改成“people”,或者把“car”改成“汽车”?
很遗憾,不修改算法胶囊的源代码目前做不到。
…
感谢你的提问!
- 识别出“person”和“car”之后,框的形状能否修改?例如从现在的方形改成圆形?
“边界框”其实不是方框,而是算法胶囊输出的多边形的精确渲染。算法胶囊可以输出任意边数的形状:你可以在 openvision capsules 代码库中的 DetectionNode 定义里看到,DetectionNode 对象有一个参数 self.coords,其中包含一个 (x, y) 点的列表。如果让它输出一个近似圆形的多边形,BrainFrame 客户端就会显示一个圆形。
- 我们用局域网内的一台摄像头测试,从动作发生到 Brainframe 显示似乎有大约 5 秒的延迟。怎样才能优化这个延迟?
可以,通过自定义管道就能做到!默认情况下,BrainFrame 会对帧进行“缓冲”,以保证更稳定的视频流体验。为避免缓冲,可以试试下面的管道:
rtspsrc location={url} latency=0 ! rtph264depay name="buffer_src" ! decodebin ! videoconvert ! appsink name="main_sink"
改动的是“latency=0”。BrainFrame 管道的默认延迟是 3000ms。请测试一下,我们会在下一个版本把它加入文档!谢谢。