显示 docker 正在运行,但我的客户端连不上服务端,提示 502 Bad Gateway。在 Linux 上显示的网页是 302 Find。有人能帮帮我吗?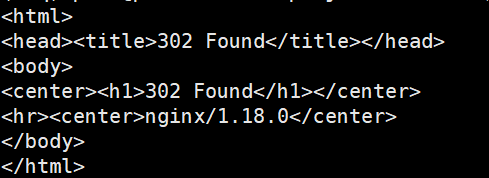
服务端报错“302 Find”,客户端无法连接服务端
存档自 BrainFrame 论坛。发布于 2020年7月2日。 13 条回复 · 1106 次浏览 由英文原帖翻译成中文。 阅读原文
你好 Meggie,欢迎来到论坛!
BrainFrame 核心服务启动失败时可能出现这种情况。能否帮我运行这条命令并附上结果?必须在 docker-compose.yml 所在的目录下运行。
docker-compose logs core > core_logs.txt非常感谢,这是我的日志。core-logs.txt (306.4 KB)
看起来 BrainFrame 运行正常。可能是我们的 HTTP 代理出了问题。能否用下面的命令重启它?
docker-compose restart http_proxy
我重启了代理,但还是不行
我找到问题了,非常感谢
很高兴听到这个消息!最后问题是什么?
我发现,如果在客户端运行时关闭服务端,数据库就会被破坏。所以我重新加载了数据库,服务端就正常了 
能再问一个问题吗?这个 API 支持 .h5 和 keras 框架吗?
你好 Meggie,
好问题!我们目前支持的库列在这里。我们自带 Tensorflow 1.15,其中包含 keras。
你应该可以像平常一样导入 keras 并使用它(包括用 h5py 加载 h5 文件,或使用 keras 封装)
import tensorflow.keras as keras
顺便说一下,运行下面这行命令,可以得到一个交互式 python 解释器,用来试验随附的库:
docker run -it --entrypoint python3 aotuai/brainframe_core:0.26.0
我很乐意在你开发算法胶囊的过程中提供更多帮助。你有这个模型的源代码可以分享吗?这样我可以帮你把它转换成算法胶囊。
问题:这个模型是开源的吗?如果你把模型/源代码发给我,我能帮上更多忙——我会帮你开始构建算法胶囊。
你在研究 tf_image_classification.py 的源代码,这很好——这有助于你理解开发者应该如何实现后端。
关于 tf_image_classification.py 的更多信息:它是为了支持用 Tensorflow Slim 代码库训练的图像分类模型而创建的,我们用那个代码库微调训练了许多在 imagenet 上预训练过的不同架构。它不适用于任意模型,只适用于用那个代码库训练的模型,因为它们在输入输出等方面遵循了特定的命名约定。
如果你想直接使用 Keras 模型,我认为更简单的做法是新写一个 Backend,完全使用 Keras 来加载模型、运行推理等。
祝顺利!
你好 Meggie,你遇到这个错误是因为 BaseBackend 要求必须存在 Backend.close() 方法。
我擅自为你构建了一个算法胶囊供你参考。我没有测试过——如果你把模型发给我,我可以修复其中的问题。注意,这个算法胶囊需要一个人体检测器!我推荐 detector_person_and_vehicles_fast。
请看一下这个算法胶囊。如果你把 model.h5 发给我,我可以帮你验证,甚至帮你写 batch_predict 方法以获得更快的速度!
我想我忘了在输入前调整图像大小……另外,了解这个模型是如何训练的很重要——训练时使用的是 RGB 还是 BGR 通道顺序?BrainFrame 提供的帧是 BGR 顺序的,所以我们可能需要翻转通道来提高准确率。
classifier_violence_v1.zip (2.0 KB)
谢谢,我去看看这个模型。
不知道能否使用输入类型为 NodeDescription.Size.NONE 的帧,并在其他算法胶囊的人体检测结果上创建一个新属性。
从技术上讲,你可以接受“NONE”作为输入,并输出带有“violent”或“non-violent”属性分类的检测结果。这有点奇怪,但我们下载页面上的 detector_fire_fast 就是这么做的。对于你的情况,我想更合理的做法是接受“person”作为输入,对人体检测结果进行裁剪并分类?顺便说一下:当你接受“person”作为输入时,“frame”参数仍然是整个画面。是否把画面裁剪到人体区域,由算法胶囊的开发者决定。
或者,如果你想把画面中所有人都标记为“violent”或“non violent”,可以接受 NodeDescription.Size.ALL 的“person”作为输入,对整个画面进行分类,然后把所有人都标记为“violent”或“non_violent”。
图片是 RGB 的,我想使用微调过的 vgg16 来分类。
了解了。你一定要在输入前翻转通道!
还有更多教程吗
有!我们的 staging.aotu.ai 网站上即将有一些教程。我会私信把详情发给你。
你好 @AOTU support,我拿到了你的模型,并修改了我的代码来配合它。这是生成的算法胶囊:https://drive.google.com/file/d/1ARSeKzn2qL8yeTHCUNjQKKK_GlMP3hw2/view?usp=sharing
它应该可以加载到 CPU 或 GPU 上,推理现在可以工作了。准确率需要你自己测试!
你会注意到,在 process_frame 方法里,我取了画面和 detection_node,并把画面裁剪到人体区域。你可能想修改这部分逻辑。
请测试一下,如果发现任何 bug 请告诉我!
很高兴它有效!如果你有兴趣(并且算法胶囊运行正常),我们一直很乐意通过我们的开源 capsule_zoo 把算法胶囊开源出去。
如果你有兴趣与世界分享这个算法胶囊,欢迎向该代码库提交 pull request。只要算法胶囊能正常工作,并且你拥有相应的授权,我们都非常欢迎!